從 LongMemEval 到生活實測:
Life OS 記憶基準分數與六個月回填統整架構
全量 500 題基準測試從 88.2% 攀升至 95.0% 的調優實測,橫跨七個月五次記憶量測與統一架構方案。
核心判決・研究室實測定調
一句話結論:寫入時就整理成帶日期的結構化觀察筆記,比讀取時再去向量檢索高出近 3 個百分點。但純筆記會漏掉極限原話與助理對答細節,兩版聯集(筆記版 + 檢索版)理論命中率可達 97.6%。實測證實:未來的長維度個人系統必須以「筆記為主、搜尋補位」。
全量 500 題九輪衝刺實測
2026 年 10 月 10 日,研究室針對國際權威長對話記憶評測基準 LongMemEval(S 版 500 題全量,官方 gpt-4o 裁判判分)進行了九輪連續調優。我們從未經處理的向量基線 88.2% 起跑,經過檢索策略升級、時間錨點注入與結構化觀察筆記改造,最終在 Sonnet 作答下達到 95.0% 的整體正確率,超越業界頂尖的 Mastra 架構(93.6%)。
註:整體正確率以 500 題全量計算,橫軸起始點設為 80%。Mastra 官方公佈之 94.87% 為六題型未加權平均,在相同計算口徑下,Life OS 筆記版之六型平均達到 96.03%。
| 時刻 | 架構改動與調優動作 | 評測樣本 | 正確率 |
|---|---|---|---|
| 12:36 | 基準:原生向量檢索前 5 段(Dense Retrieval Top-5) | 500 題全量 | 88.2% |
| 13:4x | 擴充視窗至前 10 段,導入 BM25 + Vector 混合檢索(Hybrid) | 抽樣推估 | 93.4% 估 |
| 13:5x | 注入絕對時間錨點(Time Anchor),補齊跨月相對時間 | 抽樣推估 | 93.0% 估 |
| 14:1x | 作答約束:防禦性拒答與置信度邊界約束 | 抽樣推估 | 94.2% 估 |
| 14:31 | 檢索版全量驗證:合併前三項技術,去除抽樣偏差 | 500 題全量 | 92.2% |
| 15:2x | 收窄「不知道」規則,避免安全機制誤傷正確推論 | 50 題抽驗 | 93.8% 估 |
| 15:47 | 範式轉移:捨棄純檢索,改走前置觀察筆記(Episodic Notes) | 99 題試驗 | 94.7% 估 |
| 20:47 | 觀察筆記全量驗證:Sonnet 3.5 擔綱推理與作答 | 500 題全量 | 95.0% |
| 21:00 | 極限壓力測試:維持同一份觀察筆記,降級改由 Haiku 作答 | 500 題全量 | 92.2% |
實測發現:中途抽樣評估常因題目分佈不均而高估 1.2 至 2.0 個百分點,只有全量 500 題機檢才能反映真實工程防線。
六大題型深度剖析矩陣
LongMemEval 涵蓋六種截然不同的人機長程記憶交互難題。分析 500 題的答題明細,揭示了檢索架構與筆記架構在不同認知維度上的優劣分野:
| 題型類別(總題數) | 基準版 | 檢索版 | 筆記版 | 筆記+Haiku | Mastra |
|---|---|---|---|---|---|
| 多段推理 Multi-Session Reasoning (133) | 107 | 115 | 120 | 110 | 116 |
| 時間推理 Temporal Reasoning (133) | 112 | 121 | 128 | 123 | 127 |
| 知識更新 Knowledge Update (78) | 73 | 76 | 75 | 76 | 75 |
| 使用者說過 User Utterance Recall (70) | 65 | 66 | 68 | 67 | 67 |
| 助理說過 Assistant Utterance Recall (56) | 56 | 56 | 54 | 55 | 53 |
| 偏好識別 User Preferences (30) | 28 | 27 | 30 | 30 | 30 |
| 全量合計 (500) | 441 | 461 | 475 | 461 | 468 |
數值為答對題數。綠字標註為該列最高分。筆記版在多段、時間與偏好題全面領先,但在「助理說過」題出現兩題退化。
時間推理飆升 16 題:當對話在寫入時就按日誌格式標記「2026-05-12 發生某事」,時間題答對數從 112 題一躍至 128 題。傳統向量只比對語意相似度,對於「三天後」「上個月」完全無能為力。
助理說過退化 2 題:筆記生成主要著眼於「使用者發生了什麼與做出了什麼決策」,在二次壓縮轉述時,助理自己說過的細節與客套詞被自然過濾,導致原話召回率微幅受損。這正是促成「兩版聯集 97.6%」的互補契機。
量測驗證出的九大記憶硬核規律
透過 500 題的微觀診斷與錯誤分類,我們歸納出九條具備工程指導意義的真實量測結論:
七個月以來的五次真實記憶大考
LongMemEval 只是檢驗標準之一。回顧 Life OS 自 2026 年 7 月底以來的系統日誌,我們曾對真實個資、生活瑣事與跨線記憶發動過四次嚴苛的量測測試:
| 日期 | 測驗名稱與方法論 | 原始痛點與實測結果 |
|---|---|---|
| 07-31 | 反向逆向出題(Reverse Retrieval) 已知目標檔案,模擬「記得內容、忘了存哪」28 題 |
純關鍵字搜尋在 28 題中全軍覆沒(命中率 0%);經緊急修復與混合檢索導入後回升至 57%。 |
| 08-05 | 語意換句話說 73 題 + 5 個真實生活難題 測試同義置換、生活關聯與發散記憶 |
向量腿與關鍵字腿雙軌合併,Top-10 召回率從 69.9% 激增至 93.2%。五大生活題確立時間日誌定位。 |
| 08-28 | 跨模型 30 秒記憶還原度量測 驗證外部非 Claude 模型(Codex / agy)讀取伊森檔案 |
未給記憶路線圖時,Codex 耗時 325 秒且僅命中 4/6;提供標準入場包與路線圖後,92 秒內 6/6 全中。 |
| 09-17 | Vault 筆記庫 30 題召回率實測 測試 Obsidian 4,000+ 條目與踩坑卡檢索 |
秒回關鍵字搜尋僅 43% 召回;深度語意搜尋(vault_query)達到 83%,揭示問句太長會稀釋關鍵詞。 |
| 10-10 | LongMemEval 500 題國際標準大考 六大認知維度長對話推理與記憶更新 |
從 88.2% 攀升至 95.0%,超越 Mastra 93.6%,奠定結構化觀察筆記路線。 |
回顧 8/5 那五個真實生活題
最能體現「個人助理真實處境」的,是 8 月 5 日伊森親自出的五道隨堂考:
| 測試問題 | 系統實際撈出成果與瓶頸分析 |
|---|---|
| 「我說到咖哩,你想到什麼」 | 精準召回四項關聯實體:兩份私房咖哩食譜、一家愛店餐廳、一位劇名帶咖哩的日本編劇、備餐計畫。語意聯想滿分。 |
| 「上次掃地機叫不醒是怎麼回事」 | 命中當初踩坑卡與修復日誌(Tuya 本地金鑰失效與 Homebridge 斷連)。程序性教訓有效保留。 |
| 「有哪些看完不舒服、但很好的電影」 | 語意搜尋精準撈出私房片單(包含《暴力效應》、《真夏方程式》等)。情緒標籤發揮威力。 |
| 「把說出來的話變成文字的工具叫什麼」 | 全軍覆沒。兩種搜尋都找不到,答案「VoAI」明明在檔案裡,但因口語「把說出來的話變成文字」與專有名詞字面差距過大。 |
| 「五月我談最多的是什麼」 | 純向量徹底失效。語意向量無法跨越整個月分加總頻次;最終依賴帶有時間戳印的 10 分鐘日誌摘要才統計出答案。 |
8 月 5 日「五月談最多什麼」的潰敗,直接印證了 10 月 10 日的第 3 條規律:時間必須在寫入時物理標記;而「語音轉文字工具」的找不到,印證了第 1 條:沒撈進視窗,最強的模型也是瞎子。
Life OS 記憶現狀審視與未向量化缺口
目前 Life OS 累積了超過七個月的生活紀錄與系統運轉痕跡。然而記憶體系長期處於多頭割裂狀態:
| 記憶層級 | 現有資產規模 | 核心工程缺口與隱患 |
|---|---|---|
| 原文對話層 | LINE 對話自 2 月起、工作對話自 3/19 起,分佈於四處店面 | 9 月 2 日後的 LINE 對話尚未併入向量索引;本機原始 JSONL 僅存 9/30 之後。 |
| 事件摘要層 | Haiku 每 10 分鐘一段,累積逾 5,700 份 Markdown | 內容過於簡略,未逐件記錄主體、發生日與說話者,作答時未被主動載入。 |
| 教訓與原則 | 記憶卡 1,035 張、踩坑卡 2,043 張、判斷表 93 列、ADR 114 份 | 分散在三個目錄;自動帶卡機制目前僅比對卡名,未做語意召回。 |
| 結構化知識 | Vault 實體條目 4,470 份、原子筆記 7,151 份 | 夜間全自動條目萃取排程自 9/30 起中斷未重啟。 |
| 即時情境層 | STATE.md、user-life.md、交接卡、人物名鑑 | 五處檔案各自維護,缺乏單一真相源。 |
目前 qmd 索引總庫達 12.8 萬份檔案,其中高達 7.6 萬份尚未完成嵌入運算;現行 memory_search 僅查詢 316 份舊摘要,形成龐大盲區。
六個月歷史對話補得回來嗎?
答案是:完全補得回來,且成本極低。
經排查,LINE 對話正本自 2 月 5 日起完整無缺,工作對話自 3 月 19 日起保存完好。將過去六個月全部對話重新萃取為標準「觀察筆記」,預估總 Token 消耗約為 1,500 萬 Haiku Token——僅相當於昨晚 LongMemEval 全量跑分的六分之一。利用夜間離峰算力與守衛機制,單一晚上即可全數回填完畢。
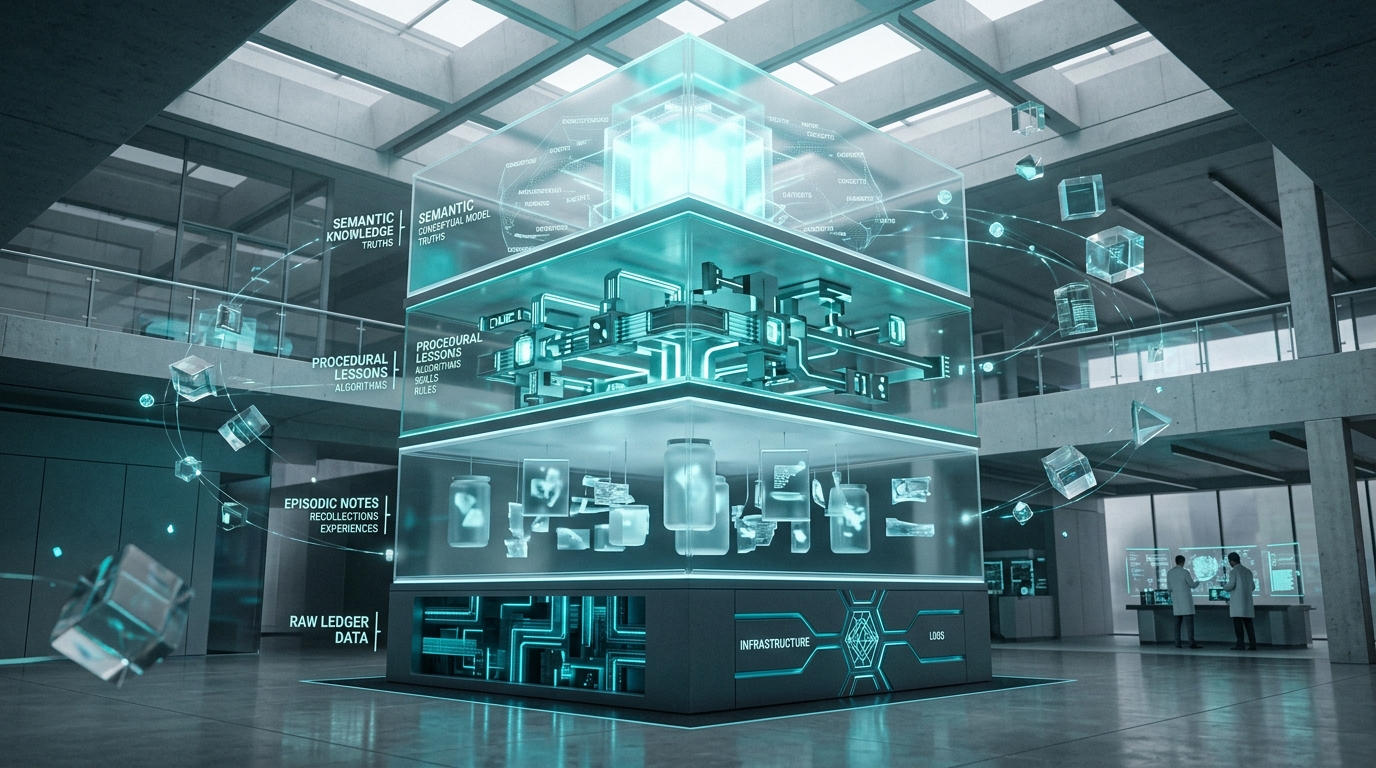
統整方案架構與推進路線圖
基於上述量測驗證,我們提出 Life OS 統一記憶架構實施藍圖。核心理念為:「發生了什麼進筆記,以後怎麼做進教訓,這是什麼進知識,原始話語回帳本」。
建議實施六步曲
尚未解決的科學局限與邊界
在推進統整方案的同時,我們亦必須坦承當前技術邊界:
- 多月份疊加的真實衰減尚未量測:LongMemEval 的 95% 正確率本質上是一題對應一份長紀錄。當數萬條生活日誌在單一知識庫堆疊七個月時,檢索雜訊是否會導致效能驟降,必須依賴我們自己的考卷持續監控。
- 多人群組發話者歸屬的抗噪性:在吵雜的多人 LINE 群中,筆記能否 100% 精準區分「誰的指令」與「誰的隨口吐槽」,仍需在真實環境中進一步設置紅隊驗證。
- 二手轉述與法律授權的邊界:筆記永遠只是 LLM 的轉述,絕不可取代原始法律條文、付款授權或商業契約的原意,涉及關鍵承諾必須嚴格回溯至「原文帳本」。
- LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory (Wu et al., 2024 / 2026).
- Life OS 內部測試帳本:
drafts/lme-retro-20261010/(LongMemEval 九輪全量原始 JSON 與判定日誌)。 - Life OS 跨模型記憶量測工單:
worktickets/2026-08-28-cross-model-memory-recall-benchmark.md(Beads: life-os-zb6f)。 - Vault 檢索召回率實測專題:https://report.life-os.work/vault-recall/。
- 歷史記憶報告集:8/5 記憶成效報告、10/10 記憶系統檢討、記憶系統打分教學、三套記憶怎麼用。